گفتگو با هوش مصنوعی خوب پیش میرود، ولی ناگهان میبینید اعتبار حسابتان خیلی زودتر از انتظار تمام شده است. سؤالهایتان سختتر نشده و جوابها هم طولانیتر نشدهاند. پس این همه توکن کجا رفت؟
بیشتر وقتها مشکل از مدل یا قیمت نیست. مشکل از چند عادت کوچک است که پنهانی مصرف را چند برابر میکنند: گفتگویی که هیچوقت بسته نمیشود، اسکرینشاتی که جای متن فرستاده میشود، یا مدل گرانقیمتی که برای یک ترجمهٔ ساده انتخاب شده است. در این راهنما اول میبینیم توکن دقیقاً کجا مصرف میشود. بعد ۲۰ روش عملی برای کاهش مصرف توکن را مرور میکنیم: از عادتهای ساده در چت تا تنظیمات Claude Code، Codex، Gemini CLI و Cursor برای برنامهنویسها.
خلاصه در یک نگاه
برای هر موضوع یک گفتگوی تازه باز کنید. هر پیام، کل گفتگوی قبلی را دوباره برای مدل میفرستد. گفتگوی طولانی یعنی هر پیام گرانتر از قبلی.
به جای عکس و PDF، متن بفرستید. فقط همان بخشی را بفرستید که لازم است.
مدل را با کار جور کنید. برای ترجمه، خلاصه و ایمیل، مدل سبک کافی است. مدل قوی را برای کارهای پیچیده نگه دارید.
طول جواب را مشخص کنید. توکنهای خروجی معمولاً چند برابر توکنهای ورودی قیمت دارند.
اگر برنامهنویس هستید، از دستورهای /clear و /compact استفاده کنید و پوشههای بزرگ را از دسترس ابزار بیرون بگذارید.
توکن چیست و چرا زود تمام میشود؟
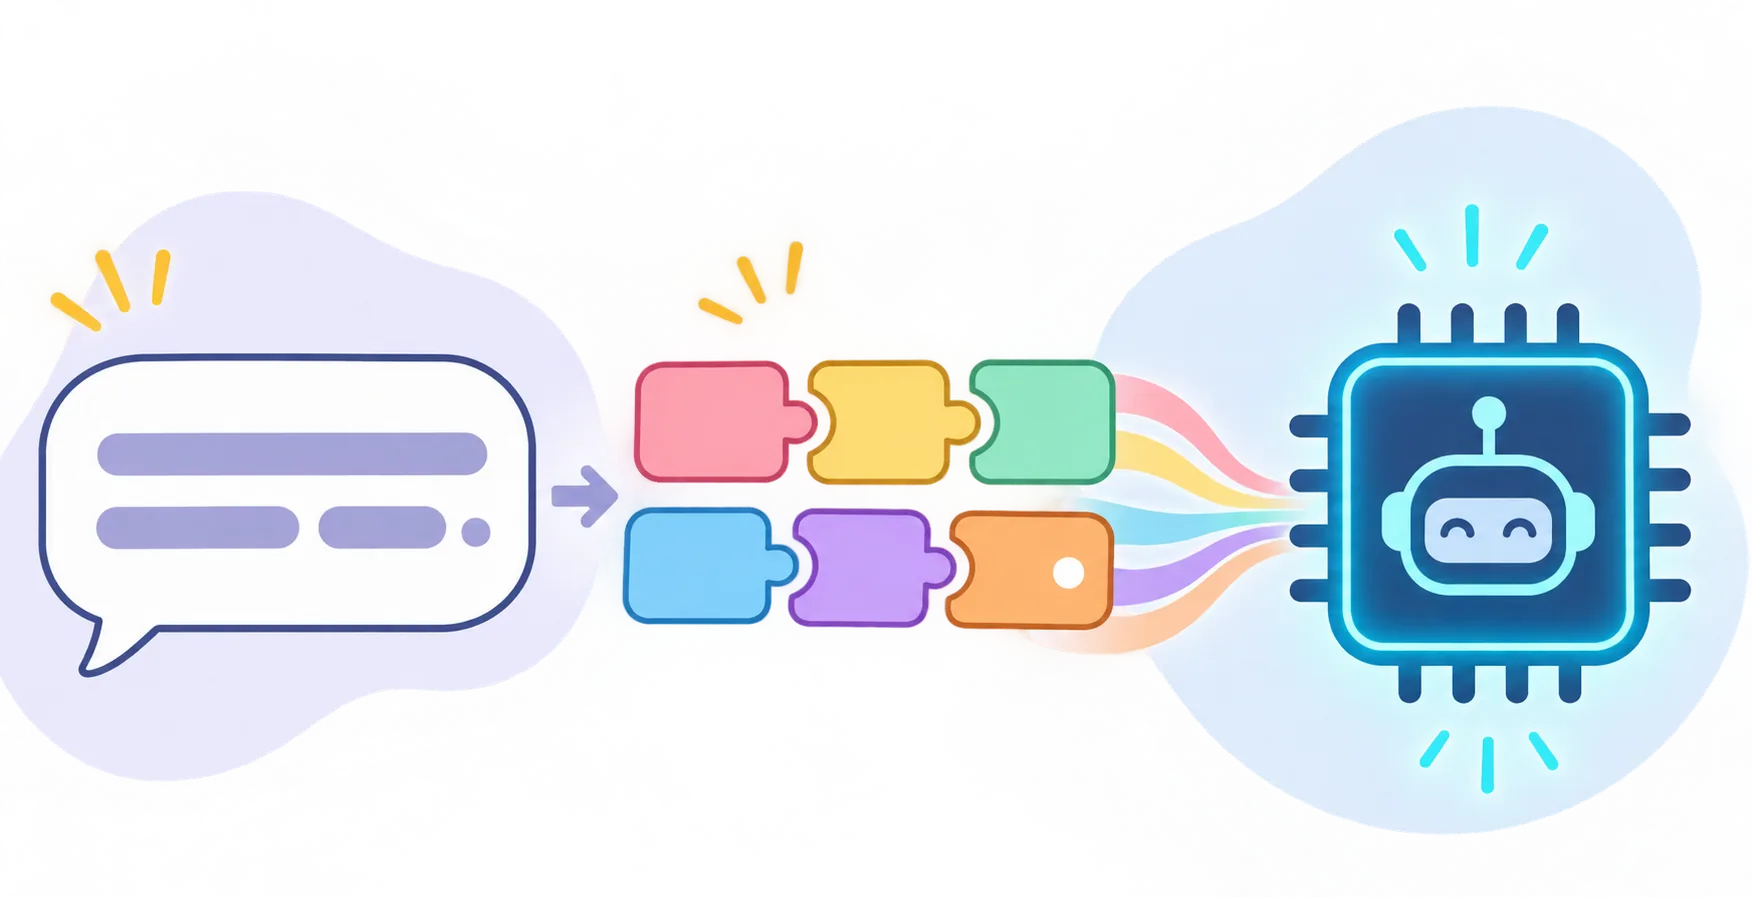
مدلهای زبانی متن را کلمهبهکلمه نمیخوانند. متن به تکههای کوچکی به اسم توکن شکسته میشود. یک توکن ممکن است یک کلمهٔ کوتاه، بخشی از یک کلمه یا یک علامت نگارشی باشد. هزینهٔ هر درخواست بر اساس تعداد همین توکنها حساب میشود: توکنهایی که میفرستید (ورودی) و توکنهایی که مدل مینویسد (خروجی). اگر میخواهید محاسبهٔ دقیق هزینه را با مثال ببینید، راهنمای نحوهٔ محاسبهٔ هزینهٔ مدلهای زبانی را بخوانید.
اما نکتهای که بیشتر کاربران نمیدانند و دلیل اصلی تمام شدن سریع اعتبار است، این است:
هر پیام، کل گفتگو را دوباره میفرستد
مدل زبانی بین دو پیام چیزی را در ذهن نگه نمیدارد. برای اینکه بداند چه گفتهاید، در هر نوبت کل تاریخچهٔ گفتگو همراه پیام جدید برایش فرستاده میشود و دوباره خوانده میشود. (دربارهٔ این موضوع در مقالهٔ حافظه در مدلهای زبانی بیشتر نوشتهایم.) یعنی پیام سیام شما فقط یک پیام نیست؛ بیستونه پیام قبلی و جوابهایشان را هم با خودش میبرد.
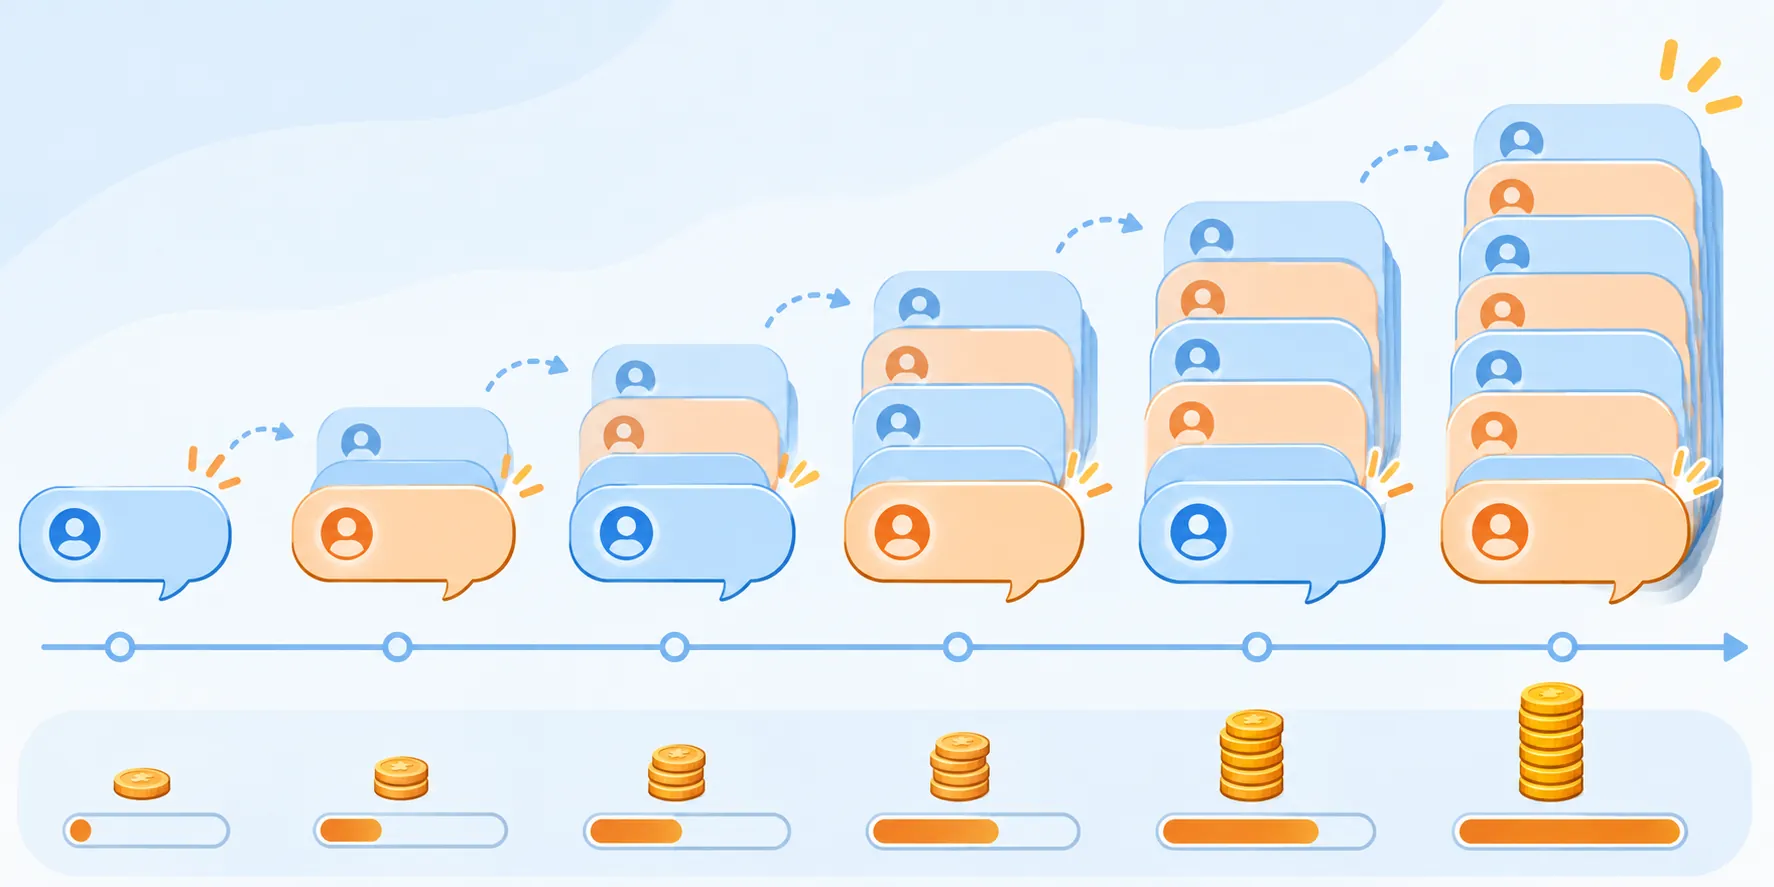
یک مثال ساده: فرض کنید هر نوبت گفتگو (سؤال شما و جواب مدل) حدود ۵۰۰ توکن به تاریخچه اضافه میکند.
| روش کار | توکن ورودیای که در کل خوانده میشود | نتیجه |
|---|
| ۳۰ پیام پشتسرهم در یک گفتگو | حدود ۲۳۲٬۵۰۰ توکن | هر پیام از قبلی گرانتر است |
| همان ۳۰ پیام در ۳ گفتگوی جدا (هر کدام ۱۰ پیام) | حدود ۸۲٬۵۰۰ توکن | حدود دو سوم کمتر |
کار و پیامها یکی است؛ فقط با جدا کردن موضوعها، مصرف ورودی به حدود یک سوم رسیده است. بیشتر روشهای این راهنما در واقع راههایی برای کوچک نگه داشتن همین تاریخچه هستند.
چه چیزهایی توکن مصرف میکنند؟
| منبع مصرف | چرا مهم است |
|---|
| تاریخچهٔ گفتگو | در هر پیام دوباره خوانده میشود و با طولانی شدن گفتگو مدام بزرگتر میشود |
| فایل، عکس و PDF | یک عکس یا یک صفحهٔ PDF میتواند به اندازهٔ چند صفحه متن توکن بگیرد، و تا آخر گفتگو در تاریخچه میماند |
| جواب مدل (خروجی) | معمولاً چند برابر ورودی قیمت دارد؛ جوابهای طولانی و تکراری گران تمام میشوند |
| فکر کردن مدل | در مدلهای استدلالی، متنی که مدل پیش از جواب «فکر میکند» هم توکن خروجی حساب میشود، حتی اگر آن را نبینید |
| دستورالعملهای ثابت | دستورالعملهای دستیار، فایلهایی مثل CLAUDE.md و تعریف ابزارها در هر پیام دوباره فرستاده میشوند |
عادتهای گفتگو: بیشترین صرفهجویی با کمترین زحمت
۱. برای هر کار یک گفتگوی تازه باز کنید
وقتی کارِ ترجمهٔ یک متن تمام شد و حالا میخواهید ایمیل بنویسید، همان گفتگو را ادامه ندهید. مدل برای نوشتن ایمیل به متن ترجمهشده نیازی ندارد، ولی اگر در همان گفتگو بمانید، هزینهٔ خواندن آن را در هر پیام میپردازید. قاعدهٔ ساده: موضوع عوض شد، گفتگو هم عوض شود.
۲. وقتی مدل راه اشتباه رفت، از اول بنویسید
اگر جواب اول اشتباه بود، فرستادن پنج پیام اصلاحی پشتسرهم («نه، کوتاهتر»، «رسمیتر»، «آن بخش را نگه دار») هم گران است و هم معمولاً نتیجهٔ بدتری میدهد، چون جوابهای اشتباه قبلی در تاریخچه میمانند و مدل را گیج میکنند. بهتر است پیام اول را ویرایش کنید یا گفتگوی تازهای باز کنید و درخواست را یکباره و کامل بنویسید.
۳. گفتگوی طولانی را خلاصه کنید و در چت تازه ادامه دهید
گاهی کار واقعاً طولانی است و نمیخواهید زمینه را از دست بدهید. در این حالت از مدل بخواهید خلاصهای از وضعیت فعلی بنویسد، و آن خلاصه را در یک گفتگوی تازه بچسبانید:
تا اینجای گفتگو را در حداکثر ۱۵۰ کلمه خلاصه کن: هدف کار، تصمیمهایی که گرفتیم، و قدم بعدی. فقط نکتههایی را بنویس که برای ادامهٔ کار لازم است.
به این ترتیب به جای چند هزار توکن تاریخچه، با چند صد توکن خلاصه ادامه میدهید.
۴. وسط یک کار سنگین مکث طولانی نکنید
بسیاری از سرویسها بخش تکراری ابتدای گفتگو را برای چند دقیقه در حافظهٔ موقت (کش) نگه میدارند و خواندن دوبارهٔ آن را با تخفیف زیادی حساب میکنند. اگر چند دقیقه بیشتر مکث کنید، کش پاک میشود و پیام بعدی باید کل گفتگو را دوباره با قیمت کامل بخواند. (OpenAI جزئیات این سازوکار را در مستندات Prompt Caching توضیح داده است.) اگر کار طولانی دارید، آن را یکجا انجام دهید، یا بعد از استراحت با یک خلاصه در گفتگوی تازه ادامه دهید.
۵. سؤالهای مرتبط را در یک پیام بپرسید
سه سؤال کوتاه در سه پیام جدا یعنی سه بار خواندن کل تاریخچه. اگر سؤالها به هم مربوطاند، آنها را در یک پیام شمارهدار بفرستید. مدل هر سه را با یکبار خواندن جواب میدهد.
ورودی کمتر، همان نتیجه
۶. متن را کپی کنید، نه اسکرینشات بگیرید
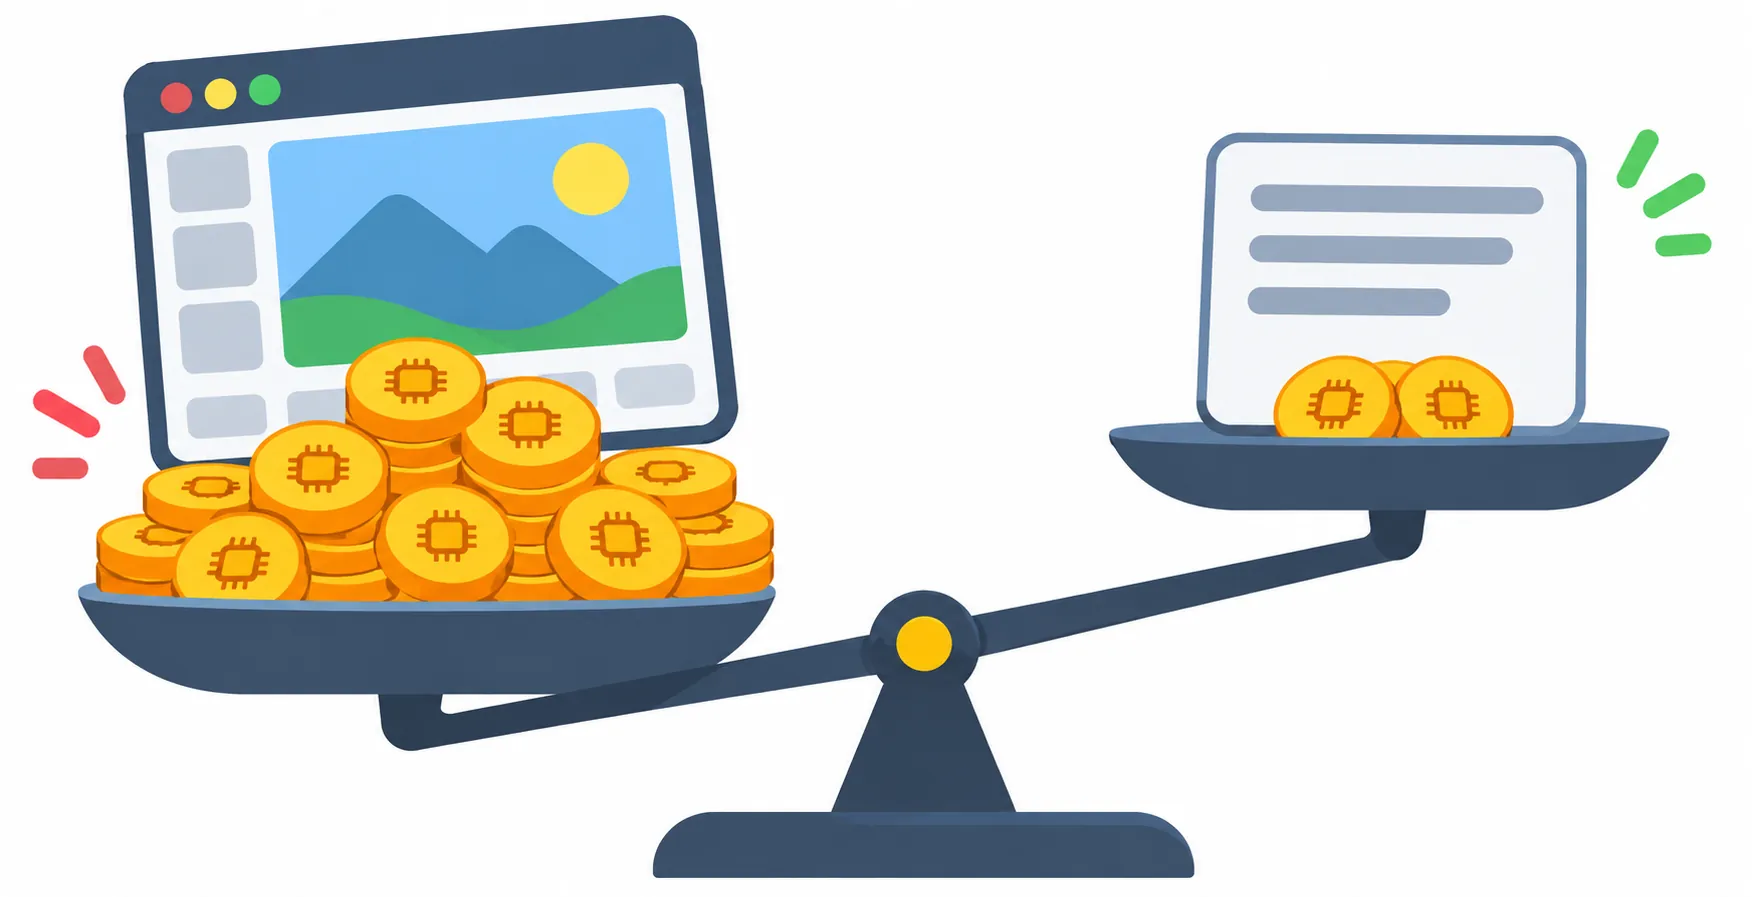
عکس و PDF از گرانترین ورودیها هستند. یک اسکرینشات از چند خط متن میتواند چند برابر خود آن متن توکن بگیرد، و هر صفحهٔ PDF در بعضی مدلها هم بهصورت متن و هم بهصورت تصویر پردازش میشود. اگر محتوا متنی است، آن را کپی کنید. عکس را فقط وقتی بفرستید که خود تصویر مهم است، مثل نمودار، طراحی یا عکس محصول.
۷. فقط بخش لازم را بفرستید
برای پرسیدن دربارهٔ یک بند از قرارداد، کل قرارداد ۴۰ صفحهای را نفرستید. برای پیدا کردن یک باگ، کل فایل ۲۰۰۰ خطی را نچسبانید؛ تابع مشکلدار و پیام خطا را بفرستید. هرچه در گفتگو بیاید، تا آخر آن گفتگو در هر پیام دوباره خوانده میشود.
۸. درخواست دقیق بنویسید
درخواست مبهم یعنی جواب کلی، بعد سؤال دوباره، بعد جواب دیگر. هر دور رفتوبرگشت هم هزینهٔ خودش را دارد. این دو درخواست را مقایسه کنید:
❌ «یه متن برای محصولم بنویس.»
✅ «برای صفحهٔ محصول یک فروشگاه اینترنتی، توضیح ۸۰ کلمهای بنویس برای کیف چرمی دستدوز قهوهای. مخاطب: خانمهای ۲۵ تا ۴۰ سال. لحن: صمیمی ولی حرفهای. دو ویژگی اصلی: چرم طبیعی و دوخت دستی.»
درخواست دوم معمولاً در همان بار اول جواب قابل استفاده میگیرد. اگر میخواهید این مهارت را جدیتر یاد بگیرید، آموزش کامل پرامپتنویسی را ببینید.
۹. دستورالعملهای ثابت را کوتاه نگه دارید
اگر برای دستیارتان دستورالعمل همیشگی نوشتهاید (مثل لحن، نقش یا قوانین پاسخگویی)، این متن در هر پیام دوباره فرستاده میشود. دستورالعمل ۲۰۰۰ کلمهای در یک گفتگوی ۵۰ پیامی یعنی ۱۰۰ هزار کلمه ورودی اضافه. دستورالعمل را کوتاه، دقیق و بدون تکرار بنویسید. اگر برای کارهای تکراری از دستیارهای هوش مصنوعی استفاده میکنید، همین قاعده دربارهٔ دستورالعمل آنها هم صدق میکند.
۱۰. بدانید متن فارسی توکن بیشتری میگیرد
بیشتر مدلها روی متن انگلیسی بهینهتر توکنسازی میکنند؛ معمولاً یک متن فارسی نسبت به معادل انگلیسیاش توکن بیشتری مصرف میکند. این دلیل نمیشود فارسی ننویسید، چون کیفیت جواب برای مخاطب فارسی مهمتر است. ولی وقتی متن خیلی طولانیای مثل مستندات فنی، لاگ یا کد را فقط برای تحلیل میفرستید، فرستادن نسخهٔ اصلی انگلیسی به جای ترجمهاش هم ارزانتر است و هم دقیقتر.
مدل درست برای کار درست
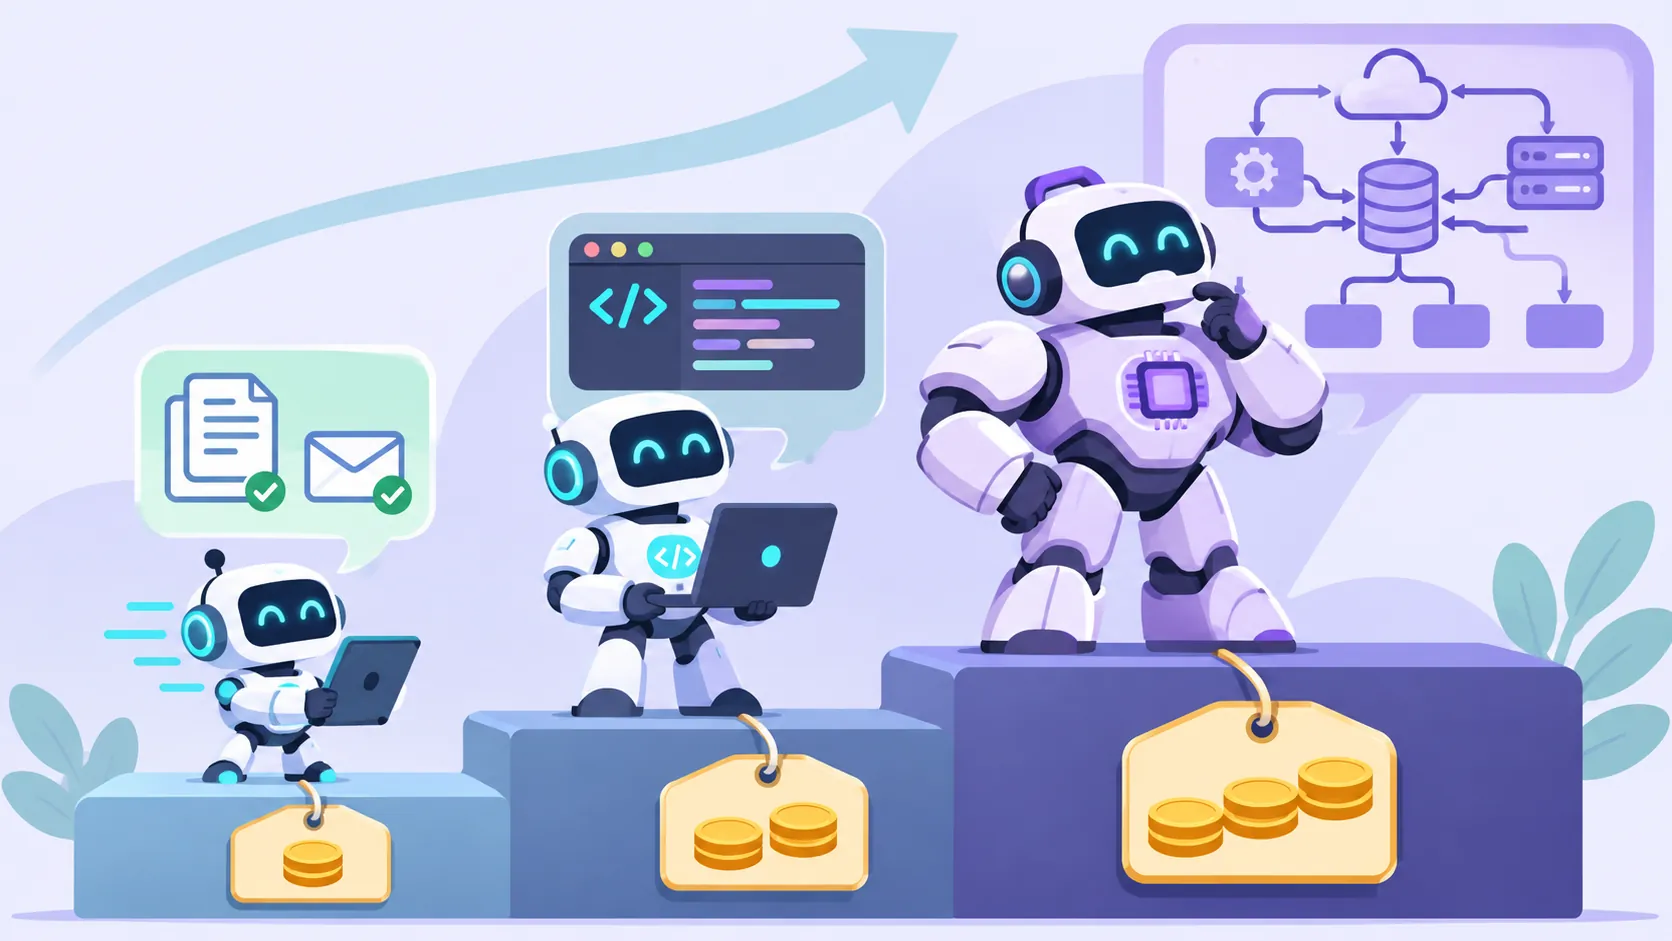
۱۱. برای کار ساده از مدل سبک استفاده کنید
قیمت مدلهای سبک و قوی گاهی چند ده برابر با هم فرق دارد، ولی برای خیلی از کارهای روزمره نتیجهشان تقریباً یکی است. یک راهنمای کلی:
| نوع کار | مدل پیشنهادی | نمونه |
|---|
| ترجمه، خلاصه، بازنویسی، ایمیل | مدل سبک و سریع | Claude Haiku، Gemini Flash، نسخههای mini مدلهای GPT |
| نوشتن محتوا، کدنویسی روزمره، تحلیل متن | مدل متوسط | Claude Sonnet، مدلهای اصلی GPT |
| استدلال پیچیده، طراحی سیستم، باگهای سخت | مدل قوی | Claude Opus، Gemini Pro، مدلهای استدلالی |
اول کار را با مدل سبک امتحان کنید؛ فقط اگر نتیجه کافی نبود، سراغ مدل قویتر بروید. در هوشیار۲۴ میتوانید برای هر گفتگو مدل را جدا انتخاب کنید و مثلاً جمینای را به فارسی برای کارهای روزمره به کار ببرید.
۱۲. سطح «فکر کردن» را پایین بگذارید
مدلهای استدلالی پیش از جواب، متن زیادی را پنهانی «فکر میکنند» و این متن هم هزینهٔ خروجی دارد. اگر ابزارتان تنظیمی مثل reasoning effort یا حالت تفکر دارد، برای کارهای روزمره آن را روی سطح پایین بگذارید و فقط برای مسئلههای واقعاً سخت بالا ببرید. در مقالهٔ مدلهای استدلالی توضیح دادهایم کدام کارها واقعاً به این مدلها نیاز دارند.
۱۳. مدل قوی برای برنامهریزی، مدل سبک برای اجرا
برای کارهای بزرگ، یک بار با مدل قوی نقشهٔ کار را دربیاورید: ساختار مقاله، طرح کلی کد یا مراحل پروژه. بعد اجرای قدمبهقدم را به مدل سبکتر بسپارید. بخش گران کار فقط یک بار انجام میشود.
خروجی کوتاهتر
۱۴. طول و قالب جواب را مشخص کنید
اگر نگویید، مدل معمولاً مقدمه، توضیح اضافه و جمعبندی هم مینویسد. چون توکن خروجی گرانتر است، همین عبارتهای ساده تفاوت محسوسی ایجاد میکنند:
۱۵. فقط بخش تغییرکرده را بخواهید
وقتی میخواهید یک پاراگراف از متن ۲۰۰۰ کلمهای اصلاح شود، از مدل نخواهید کل متن را دوباره بنویسد. بگویید «فقط پاراگراف سوم را بازنویسی کن». در کدنویسی هم همینطور: «فقط تابع تغییرکرده را بنویس، نه کل فایل.»
برای برنامهنویسها: کاهش مصرف توکن در Claude Code، Codex، Gemini CLI و Cursor
ابزارهای کدنویسی هوش مصنوعی بیشترین توکن را مصرف میکنند، چون فایلها، خروجی دستورها و تاریخچهٔ طولانی کار را مدام در کانتکست نگه میدارند. اگر از این ابزارها از طریق API هوشیار۲۴ استفاده میکنید، هزینهٔ هر درخواست بر اساس همین مصرف از کیف پولتان کم میشود. پس این پنج روش مستقیماً روی هزینهٔ شما اثر دارند.
۱۶. کانتکست را پاک یا خلاصه کنید
هر ابزار دستوری برای شروع دوباره و دستوری برای خلاصه کردن گفتگو دارد. بین کارهای مستقل کانتکست را پاک کنید، و وقتی وسط یک کار طولانی کانتکست بزرگ شد، آن را خلاصه کنید:
| ابزار | شروع تازه | خلاصه کردن کانتکست | دیدن مصرف |
|---|
| Claude Code | /clear | /compact | /context و /cost |
| Codex CLI | /new | /compact | /status |
| Gemini CLI | /clear | /compress | /stats |
| Cursor | چت تازه برای هر کار | — | — |
در Claude Code میتوانید به /compact بگویید چه چیزی را حتماً نگه دارد، مثلاً /compact تصمیمهای مربوط به ساختار دیتابیس را نگه دار.
۱۷. ببینید چه چیزی کانتکست را پر کرده
در Claude Code دستور /context نشان میدهد چه بخشی از کانتکست را فایلها، ابزارها و تاریخچه گرفتهاند. گاهی مقصر یک فایل لاگ بزرگ است که یک بار خوانده شده و تا آخر سشن مانده، یا یک MCP سرور که دهها ابزار تعریف کرده است. اول اندازه بگیرید، بعد بهینه کنید.
۱۸. پوشههای بزرگ را از دسترس ابزار بیرون بگذارید
پوشههایی مثل node_modules، dist، لاگها، فایلهای lock و دیتاستها هیچ کمکی به مدل نمیکنند ولی اگر خوانده شوند، کانتکست را پر میکنند. هر ابزار راهی برای کنار گذاشتنشان دارد:
Claude Code: در فایل .claude/settings.json برای خواندن این پوشهها قانون deny بگذارید، مثلاً "deny": ["Read(./node_modules/**)", "Read(./dist/**)"] زیر بخش permissions.
Gemini CLI: مسیرها را در فایل .geminiignore بنویسید.
Cursor: مسیرها را در فایل .cursorignore بنویسید، و به جای اضافه کردن کل پوشه، فقط فایلهای لازم را با @ به چت بدهید.
یک عادت مرتبط: از ابزار بخواهید خروجی دستورها را کوتاه کند. به جای چاپ کل لاگ، با tail، head یا grep فقط بخش لازم را ببیند.
۱۹. فایل دستورالعمل پروژه را کوتاه نگه دارید و MCPهای اضافه را خاموش کنید
فایلهایی مثل CLAUDE.md و AGENTS.md در هر پیام دوباره خوانده میشوند. فقط قوانینی را در آنها نگه دارید که واقعاً هر بار لازم است؛ توضیحات طولانی را به فایلهای جدا ببرید. همینطور هر MCP سرور فعال، تعریف ابزارهایش را در هر پیام به کانتکست اضافه میکند. سرورهایی را که در کار فعلی لازم ندارید، غیرفعال کنید.
۲۰. جستجوی گسترده را به سابایجنت بسپارید و مدل را با کار جور کنید
وقتی باید در کل پروژه دنبال چیزی بگردید، در Claude Code آن را به یک سابایجنت (مثل Explore) بدهید. سابایجنت فایلها را در کانتکست خودش میخواند و فقط خلاصهٔ نتیجه را برمیگرداند، پس دهها فایل وارد گفتگوی اصلی نمیشود. همچنین با /model مدل را عوض کنید: Haiku برای کارهای خیلی ساده، Sonnet برای کدنویسی روزمره، و Opus برای طراحی و باگهای پیچیده. در Codex هم با /model میتوانید مدل و سطح reasoning را انتخاب کنید؛ برای کارهای ساده مدلهای mini با effort پایین کافی است. اگر تازه با کدنویسی به کمک هوش مصنوعی آشنا شدهاید، مقالهٔ Vibe Coding را هم ببینید.
چکلیست سریع کاهش مصرف توکن
| کی | چه کار کنید |
|---|
| قبل از شروع | مدل متناسب با کار را انتخاب کنید و سطح فکر کردن را پایین بگذارید |
| موقع نوشتن درخواست | دقیق بنویسید، فقط بخش لازم را بفرستید، متن را به جای عکس کپی کنید، طول جواب را مشخص کنید |
| وسط گفتگو | سؤالهای مرتبط را یکجا بپرسید، مکث طولانی نکنید، به جای اصلاحهای پشتسرهم از اول بنویسید |
| وقتی موضوع عوض شد | گفتگوی تازه باز کنید؛ اگر زمینه لازم است، خلاصه را منتقل کنید |
| در ابزارهای کدنویسی | /clear و /compact، کنار گذاشتن پوشههای بزرگ، فایل دستورالعمل کوتاه، خاموش کردن MCPهای اضافه |
جمعبندی
بیشتر هزینهٔ اضافهٔ هوش مصنوعی از جایی میآید که دیده نمیشود: تاریخچهٔ گفتگویی که در هر پیام دوباره خوانده میشود. اگر فقط یک عادت از این راهنما بردارید، همین باشد: برای هر کار یک گفتگوی تازه. بعد سراغ انتخاب مدل مناسب و کوتاه کردن ورودی و خروجی بروید. با همین چند تغییر، معمولاً همان کارها با بخش کوچکی از اعتبار قبلی انجام میشود و جوابها هم دقیقتر میشوند، چون مدل در کانتکست خلوتتر بهتر کار میکند.